Qwen-UI-Agent van Alibaba verslaat GPT-5.6 op telefoons
Alibaba heeft Qwen-UI-Agent uitgebracht, een model dat is gebouwd om schermen te bedienen in plaats van alleen tekst te produceren. Het onderzoeksteam Tongyi-MAI zette het technische rapport op arXiv (2607.28227) en publiceerde de benchmarkscores op een projectpagina. Op vier van de vijf gepubliceerde tests staat het model boven GPT-5.6 Sol en Claude Opus 4.8.
Een model voor telefoon, pc en browser
De meeste GUI-agents richten zich op een enkel platform. Qwen-UI-Agent brengt mobiel gebruik, computerbediening, browsertaken en zoekwerk onder in hetzelfde model. Volgens het rapport wisselt het model schermhandelingen af met commando’s op de commandoregel en genereert het meerdere acties per beurt, in plaats van na elke klik terug te koppelen. Bij langere taken scheelt dat aanroepen, want elke tussenstap kost anders een nieuwe ronde langs het model.
De cijfers uit het rapport: op MobileWorld haalt Qwen-UI-Agent 82,1 procent, tegenover 70,1 procent voor GPT-5.6 Sol en 67,5 procent voor Claude Opus 4.8. Op AndroidDaily staat 97,5 procent tegenover 92,6 en 93,0 procent. Op WebArena, dat webtaken meet, komt het uit op 73,6 procent tegen 69,5 en 71,9 procent. OpenAI verlaagde vorige week nog de prijs van GPT-5.6 Sol, het model dat hier als referentie dient.
Getraind op honderd echte telefoons
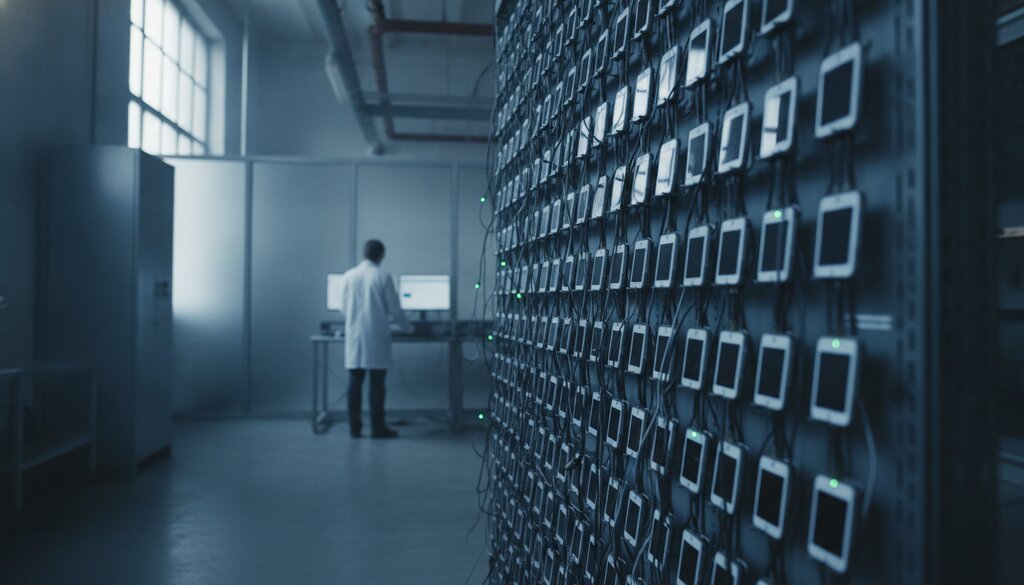
Het opvallendste deel van de aanpak zit in de trainingsomgeving. Tongyi-MAI beschrijft een opstelling met meer dan honderd fysieke smartphones en ruim 150 apps, gebruikt voor het bouwen van taken, het verzamelen van trajecten en de evaluatie. Daar hoort een aparte testset bij, MobileWorld-Real, met meer dan 400 taken verspreid over honderd apps. Op die set met echte toestellen scoort het model 92,2 procent, tegen 85,4 procent voor GPT-5.6 Sol en 84,7 procent voor Claude Opus 4.8.
Simulaties zijn goedkoper, maar missen de haperingen van echte apparaten: trage laadschermen, inlogpop-ups, meldingen die over de knop vallen. Eerder onderzoek van Princeton naar agent-skills liet al zien dat prestaties in de praktijk anders uitpakken dan op papier.
Waar het model achterblijft
Op OSWorld-v2, dat lange desktoptaken meet, ligt Claude Opus 4.8 voor met 54,8 procent tegen 40,0 procent. Dat is een flink gat en het zegt iets over waar de training zich op heeft gericht: telefoons vooral, desktop minder. Op ScreenSpot-Pro, dat het aanwijzen van elementen test, noteert het rapport 81,5 procent met zoomfunctie en 76,6 procent zonder.
Over de gewichten van Qwen-UI-Agent zelf zegt het rapport niets concreets. De voorloper van het project, MAI-UI, staat wel op Hugging Face in varianten van 2 en 8 miljard parameters, onder de Apache 2.0-licentie. Alibaba investeert stevig in AI en haalde deze maand nog 10,2 miljard dollar op met een aandelenverkoop.
Wat betekent dit
Agents die knoppen indrukken zijn een ander soort product dan agents die API’s aanroepen. Voor bedrijven met oude software zonder koppelvlak is schermbediening vaak de enige route naar automatisering, en juist daar was de betrouwbaarheid tot nu toe het probleem. Een score van 92 procent op echte toestellen betekent nog steeds dat een op de twaalf taken misgaat, dus toezicht blijft nodig. Tegelijk verschuift het zwaartepunt in agent-land richting infrastructuur en governance, zichtbaar in de overgang van A2A naar de Agentic AI Foundation en in kennislagen zoals Pinecone Nexus. Een model dat schermen betrouwbaar bedient, past daar als laatste schakel netjes in.
Lees ook

Google splitst AX-runtime en zet taken in Redis
Z.ai maakt ZCode open source na upload van Git-historie