Gates Foundation smeedt AI-coalitie voor lokale talen
De Gates Foundation heeft maandag een coalitie van zestig organisaties gepresenteerd die AI-systemen moet laten werken in talen waarvoor nu nauwelijks trainingsdata bestaat. Anthropic, Google en de OpenAI Foundation doen mee, samen met filantropische fondsen, universiteiten en lokale dataprojecten. De stichting mikt op meer dan drie miljard mensen binnen vijf jaar.
Waarom taaldata het knelpunt is
Taalmodellen leren van wat er op internet staat, en daar zijn honderden talen vrijwel afwezig. Elizabeth Kelly, bij Anthropic verantwoordelijk voor beneficial deployments, zei tegen persbureau AP dat de producten van het bedrijf “in veel Afrikaanse talen in het bijzonder” achterblijven. Het gaat niet om een cosmetisch probleem: de stichting wijst op medische vertaalfouten, waarbij een chatbot alarmerende zwangerschapsklachten verkeerd interpreteert omdat het model de taal onvoldoende beheerst.
De coalitie wil vooral bestaande initiatieven beter op elkaar aansluiten in plaats van alles opnieuw opbouwen. Mark Suzman, topman van de Gates Foundation, formuleerde het scherp: zelfs als de ontwikkeling van AI vandaag zou stilvallen, zouden deze taaldatasets alsnog nodig zijn.
Wat de deelnemers al doen
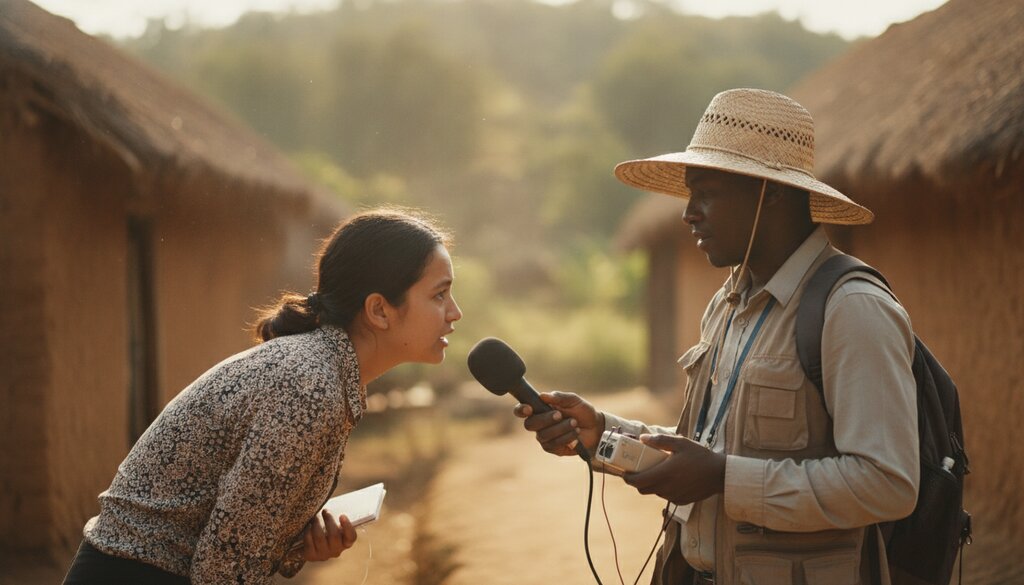
Google financiert Project Vaani, waarbij in elk district van India audio wordt verzameld. Het doel ligt boven de 150.000 uur spraak. Volgens James Manyika, senior vice president bij Google, draait het daarbij nadrukkelijk om dialecten binnen talen, niet alleen om de officiele standaardvorm. Anthropic werkte al met de stichting samen aan versnelling van vaccinonderzoek en aan een dataset met lokale gewassen voor zijn chatbot. Het Mozilla Data Collective bouwt een platform waarop gemeenschappen hun eigen taal- en cultuurdata kunnen aanleveren, met toestemming als uitgangspunt.
De Gates Foundation heeft eerder een miljard dollar gereserveerd voor AI-projecten rond gezondheidszorg, onderwijs en landbouw. Dat de grote labs hier aanschuiven past in een breder patroon: ze zoeken publieke legitimiteit op een moment dat regeringen scherper naar ze kijken. Vorige week tekenden twintig landen een AI-verklaring bij de VN, zonder de Verenigde Staten en China.
De open vraag: wie betaalt het onderhoud
Data verzamelen is een eenmalige inspanning, data onderhouden niet. Talen veranderen, en modellen worden elk kwartaal vervangen. Bill Gates zelf was op de persconferentie kritisch over de sector: volgens hem is het niet gelukt om de juiste menselijke waarden in te bouwen en de morele code te bewaken die bepaalt wat deze systemen doen.
Er speelt ook een commercieel belang. Modellen die honderden extra talen aankunnen, openen markten waar de labs nu niets verdienen. Anthropic bereidt een beursgang voor in november en Google verkoopt inmiddels eigen laptops met Gemini erin, waarbij taalbereik direct meetelt.
Wat betekent dit
Voor Nederlandse gebruikers verandert er weinig, want het Nederlands zit ruim in de trainingsdata. De relevantie zit elders: deze coalitie bepaalt mede of AI de komende jaren een instrument wordt dat ongelijkheid verkleint of juist vergroot. Wie geen taalondersteuning krijgt, mist ook de gezondheids- en onderwijstoepassingen die eraan hangen. Dat gebruikspatroon verschuift snel, zoals blijkt uit de manier waarop jongeren hun zoekgedrag al naar AI verplaatsen. Let de komende maanden op of de zestig partners daadwerkelijk datasets publiceren, of dat het bij een intentieverklaring blijft.
Lees ook

Rabbit brengt agent-besturingssysteem OS3 uit
AMD passeert duizend miljard dollar beurswaarde