
Nieuws

Gemma passeert 1 miljard downloads
Google DeepMind meldt dat zijn open Gemma-modellen een miljard downloads haalden, met ruim 100.000 varianten van ontwikkelaars. Wat zegt dat cijfer echt?
Apple Music gaat AI-muziek verplicht labelen
Apple Music toont later dit jaar zichtbare labels bij nummers die grotendeels door AI zijn gemaakt. Distributeurs moeten de opgave verplicht aanleveren, in vier categorieen.

Anthropic mikt op grootste beursgang ooit
Anthropic verwacht een beursgang die het record van SpaceX evenaart of overtreft en kan al eind augustus publiek indienen. De omzet passeerde 65 miljard dollar op jaarbasis.
Binance laat AI-agents zelf handelen in crypto
Binance opende Agent OS: ChatGPT, Claude Code en Cursor kunnen na toestemming zelf orders plaatsen via een MCP-server. Wat mag zo’n agent wel en niet?
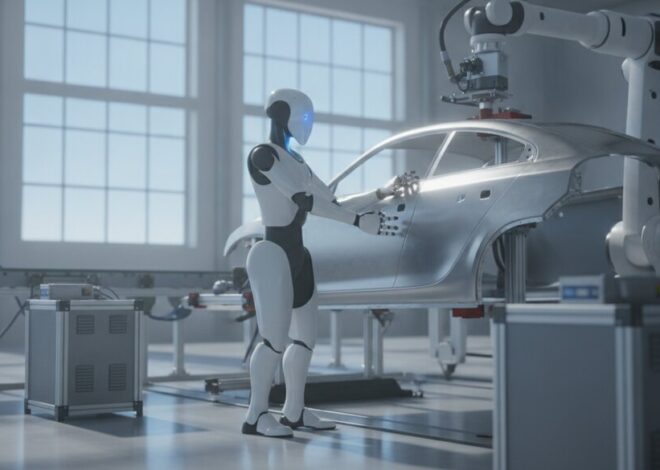
Xiaomi’s fabrieksrobot haalt 98 procent op de lijn
Xiaomi toonde op de World Robot Conference in Beijing de humanoide robot Tieda, die na vier maanden aan de autolijn 98 procent van zijn taken goed uitvoerde.
Een derde van nieuwe webpagina’s draagt sporen van AI
Pew Research analyseerde 490.000 webpagina’s: 10 procent van het web toont sporen van AI, en ruim een derde van alles na ChatGPT. Gedachtestreepjes verdubbelden.

ChatGPT kan nu je iMessage lezen en versturen
OpenAI brengt een Apple Messages-plug-in uit: ChatGPT leest, doorzoekt en verstuurt berichten op de Mac. Alleen op Apple silicon, en permanente goedkeuring is het risico.
NVIDIA betaalt 6 miljard voor licentie op Poolside-modellen
NVIDIA licentieert de codeermodellen van Poolside voor 6 miljard dollar, investeert 1 miljard en neemt 109 medewerkers over. Poolside blijft formeel zelfstandig.
Politie kan met Flock-AI zoeken op bewegingspatroon
Flock Safety bouwt met OS Investigate een AI-zoeksysteem waarmee politie mensen kan vinden op bewegingspatroon, zonder kenteken of naam. WIRED reconstrueerde de code; de ACLU waarschuwt voor vissen naar strafbare feiten.
Cerebras stopt drie wafers in een rack met de CS-4
Cerebras presenteert de CS-4, een rack met drie WSE-3 Turbo-wafers, 750 PFLOPS en ruim 4.400 tokens per seconde per gebruiker. Wat betekent dat voor inferentie?