Magnetisch geheugen belooft AI zonder datacenter
Onderzoekers van de University of Texas at Austin hebben samen met chipmaker TSMC een geheugentype op ware grootte getest dat een schrijfactie in twee nanoseconden afhandelt en daarbij zo’n twee picojoule kost. Het resultaat verscheen in Science Advances en werd deze week beschreven door Tech Xplore en Scientias. De inzet: AI-modellen laten draaien op een camera of sensor, zonder dat er een datacenter aan te pas komt.
Wat SOT-MRAM anders doet
De techniek heet SOT-MRAM, voluit spin-orbit torque magnetic random-access memory. In elke geheugencel zit een piepkleine magneet die zijn stand vasthoudt wanneer de stroom wegvalt. Data blijven dus bewaard zonder verversing, wat bij klassiek DRAM continu energie kost. Volgens Tech Xplore duurt schrijven bij concurrerende geheugensoorten al snel enkele milliseconden en gaat er honderden picojoules doorheen. Dat verschil is de kern van het verhaal.
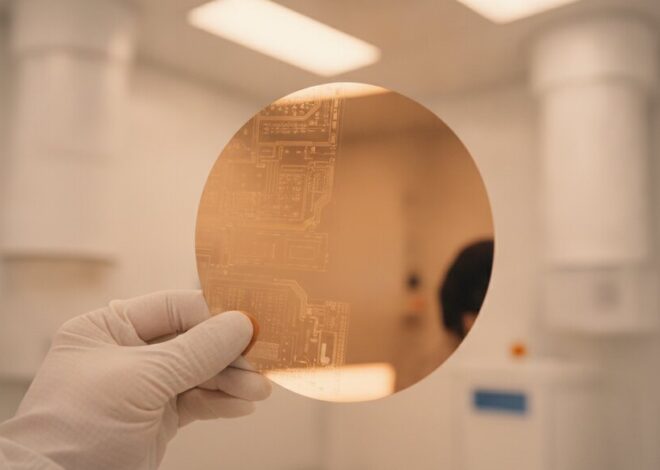
Interessanter dan de losse cijfers is waar de chips vandaan komen. Ze zijn gemaakt op volledige 300mm-wafers in de productielijnen van TSMC, dus geen handmatig gebouwd labprototype dat in de praktijk nooit reproduceerbaar blijkt. Dat maakt de stap naar commerciele productie een stuk korter. De geheugenstapeling die Cerebras bovenop de wafer zet volgt een vergelijkbare logica: rekenkracht en geheugen zo dicht mogelijk bij elkaar.
Getest op echte rekentaken
Het team liet het geheugen drie soorten AI-werk doen: inferentie met neurale netwerken, het trainen van binaire neurale netwerken en probabilistisch grafenmodelleren. De bijbehorende arXiv-publicatie noemt een tunnelmagnetoweerstand van 150 procent, bedrijfsspanning onder 1 volt, schrijfruis van 0,1 procent en een spreiding tussen afzonderlijke componenten van ongeveer 10 procent. Die laatste twee getallen tellen zwaar, want analoge geheugenarrays vallen meestal om op ruis en fabricageverschillen.
Eerste auteur Sam Liu, kort geleden gepromoveerd in Austin, formuleert het doel nuchter: SOT-MRAM-versnellers zouden energiezuinig genoeg kunnen zijn en toch nauwkeurig genoeg om CPU-gebaseerde AI-versnellers in edge-apparaten op termijn te vervangen. Het onderzoek stond onder leiding van associate professor Jean Anne Incorvia.
Waarom dit voor edge-apparaten telt
Op een sensor, bewakingscamera of robot is stroom het schaarse goed, niet rekenkracht in absolute zin. Wie daar een model lokaal wil draaien, loopt vast op geheugen dat te veel verbruikt of te traag schrijft. NVIDIA mikt met de Jetson Orin Nano 2 op precies die markt, en OpenAI zoekt met inferentiechip Jalapeno de winst ook in watts per token. Geheugen is de volgende plek waar die winst te halen valt.
Er speelt nog iets: de AI-boom trekt de geheugenmarkt scheef. Fabrikanten verschuiven capaciteit naar datacentergeheugen, waardoor laptops en telefoons duurder worden. Een geheugensoort die minder cellen en minder stroom nodig heeft voor hetzelfde werk, verlicht die druk op langere termijn.
Wat betekent dit
Voorlopig is dit onderzoek, geen product. Tussen een gepubliceerde wafer-evaluatie en geheugen in een verkoopbare camera zitten jaren van integratie, ontwerptools en prijsonderhandelingen. Wel is de barriere lager dan gebruikelijk, omdat TSMC de chips al op productieapparatuur maakt.
Voor organisaties die met AI werken is de praktische les dat de aanname “AI draait in de cloud” aan het schuiven is. Wordt lokale inferentie goedkoop genoeg, dan verandert dat de rekensom rond privacy, latency en abonnementskosten. Beelden hoeven het pand niet meer uit om geanalyseerd te worden. Dat is het soort verschuiving dat je pas ziet als de hardware er is, en die hardware komt nu uit een fabriek in plaats van een lab.
Lees ook
Liquid AI’s LFM3 draait in 1 GB op telefoon en Raspberry Pi
TSMC boekt zesde winstrecord op rij dankzij AI-chips