OpenAI meldt Codex-rate-limits: wat er aan de hand is en hoe je je workflows overeind houdt
OpenAI meldt op de eigen statuspagina dat er momenteel een toename is van gebruikers die tegen Codex rate limits aanlopen. Volgens OpenAI is er mitigatie toegepast en wordt het herstel gemonitord. Dat klinkt minder dramatisch dan een complete storing, maar voor teams die Codex in CI/CD, code-review of agent-workflows hebben ingebouwd kan het wel degelijk betekenen: taken die blijven hangen, langere doorlooptijden en onverwachte foutpieken.
Wat betekent “rate limits” in de praktijk?
Rate limits zijn limieten op het aantal verzoeken dat je in een bepaalde tijd mag doen. Als veel gebruikers tegelijk Codex gebruiken (of als capaciteit tijdelijk lager is), kun je sneller de limiet raken. OpenAI beschrijft dit incident als “increase in users hitting Codex rate limits” op status.openai.com. Belangrijk: dit is vaak geen “down”, maar wel een vorm van degradatie waarbij je systeem moet kunnen terugschakelen.
3 praktische mitigaties (die je vandaag nog kunt doorvoeren)
1) Exponential backoff + jitter. Zorg dat je client niet meteen blijft hameren. Retries met oplopende wachttijd en willekeur (jitter) voorkomen “retry storms”.
2) Queue + budgeteer requests. Zet Codex-taken (bijv. refactors, testgeneratie) in een queue en voer ze met gecontroleerde concurrency uit. Als de limiet wordt geraakt, kan de queue automatisch vertragen in plaats van falen.
3) Fallbacks voor kritieke paden. Maak onderscheid tussen “must succeed” (bijv. security checks) en “nice to have” (bijv. code-suggesties). Voor must-succeed kun je tijdelijk uitwijken naar een alternatief model/provider of naar een on-prem flow. We schreven eerder al over waarom on-prem coding AI weer aandacht krijgt in OpenAI en Dell brengen Codex naar het datacenter.
Waarom statusmonitoring nu belangrijker is dan ooit
Een opvallend patroon: veel teams monitoren wel “is de API up?”, maar niet “loopt mijn AI-keten nog binnen SLO?”. De OpenAI statuspagina is de signaalbron, maar jij moet het vertalen naar jouw impact (foutpercentages, wachttijd, job-latency). Ter context: GitHub meldt op githubstatus.com “All Systems Operational”, en Claude/Anthropic staat eveneens op groen via status.claude.com. Dat helpt bij triage: ligt het aan je eigen pipeline of aan één leverancier?
Voor een bredere aanpak (alerting, runbooks en communicatie) kun je teruggrijpen op ons artikel OpenAI-diensten lijken weer stabiel, maar storingsmonitoring blijft cruciaal en de lessons learned uit Claude had verhoogde error rates: zo bouw je je app robuuster.
Wat betekent dit voor bedrijven en developers?
Codex-rate-limits zijn een reality check: AI is steeds vaker een productie-afhankelijkheid. Wie AI in de “happy flow” stopt zonder throttling, queues en fallbacks, krijgt vroeg of laat pijn. De winnaars zijn teams die AI benaderen als elk ander extern platform: met budgetten, degrade-modes en duidelijke afspraken over wat er gebeurt als capaciteit krapper wordt.
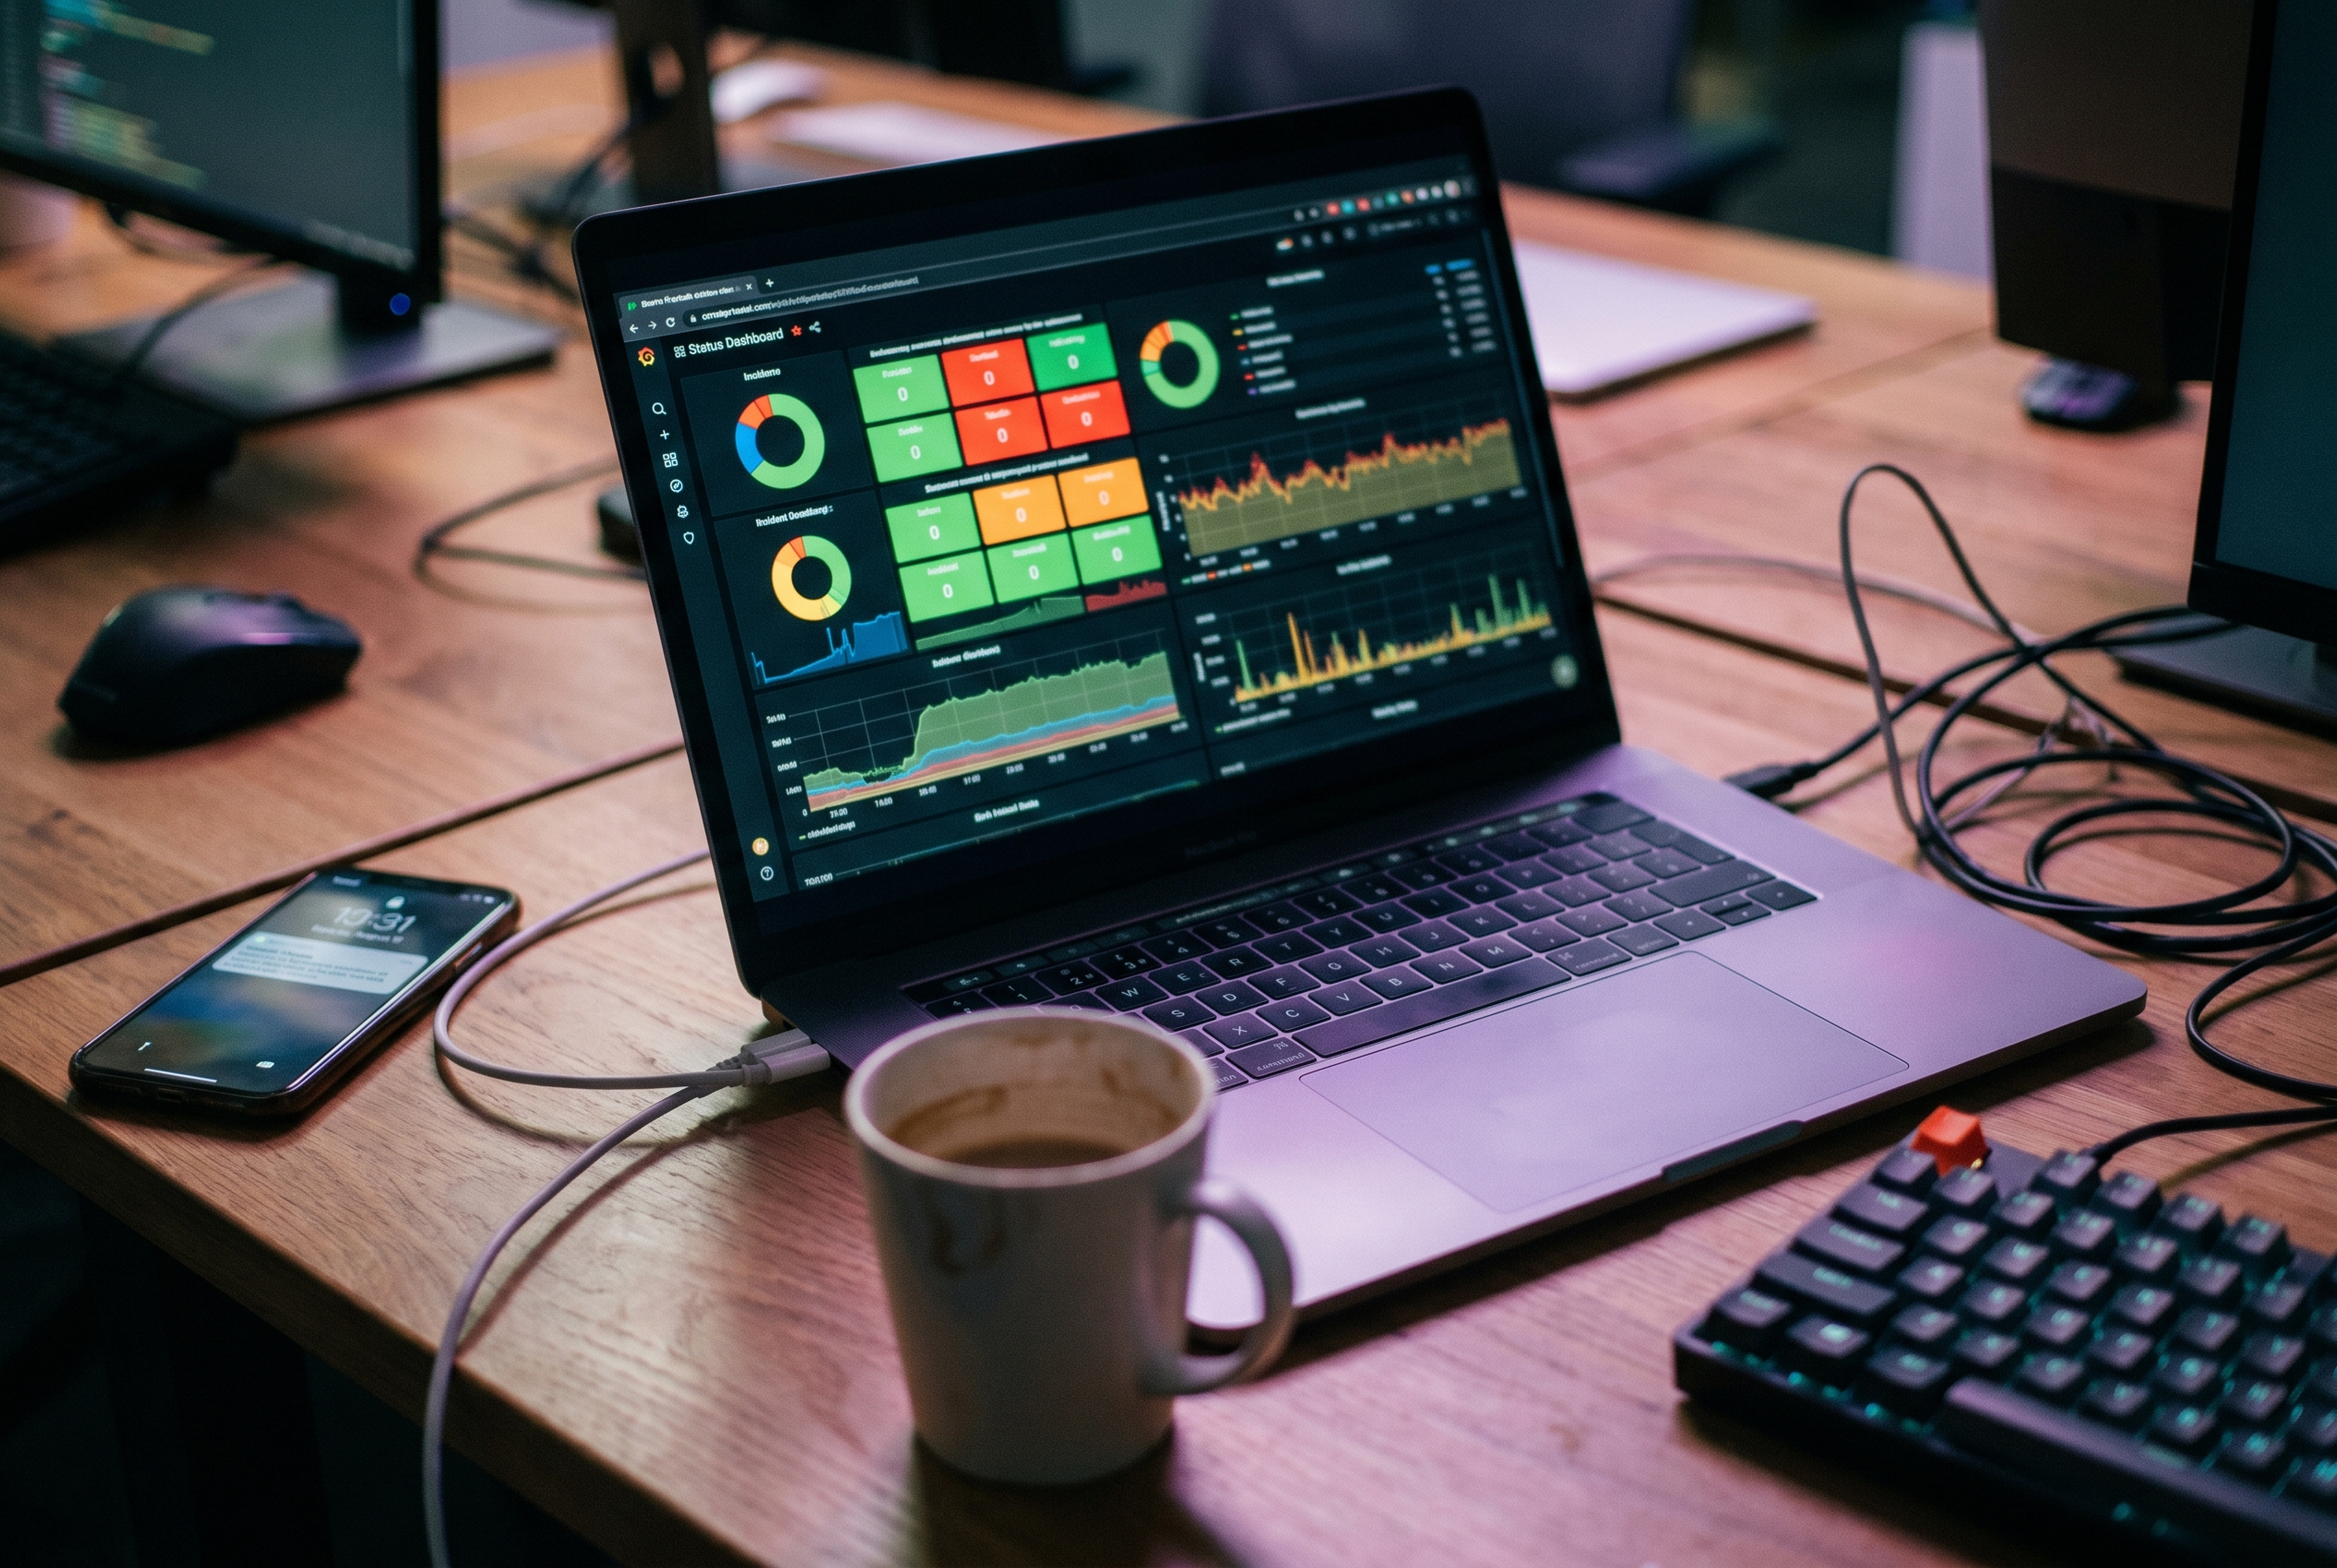
Praktisch: maak één dashboard met (1) Codex error rate, (2) gemiddelde latency, en (3) queue depth. Met die drie cijfers kun je bij het volgende incident rationeel beslissen: vertragen, uitwijken of tijdelijk uitschakelen.
Lees ook
FBI arresteert OpenAI-engineer om verborgen microfoon
Anthropic ontvangt vandaag beleggers voor beursgang