Optische chip ziet vijftien deepfakes in één keer
Een onderzoeksgroep van UCLA heeft een detector gebouwd die vijftien deepfakevideo’s tegelijk beoordeelt, en die het grootste deel van dat rekenwerk met licht doet in plaats van met transistors. De resultaten staan sinds 1 oktober in het vakblad eLight, onder de titel “Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection”.
Licht doet het voorwerk
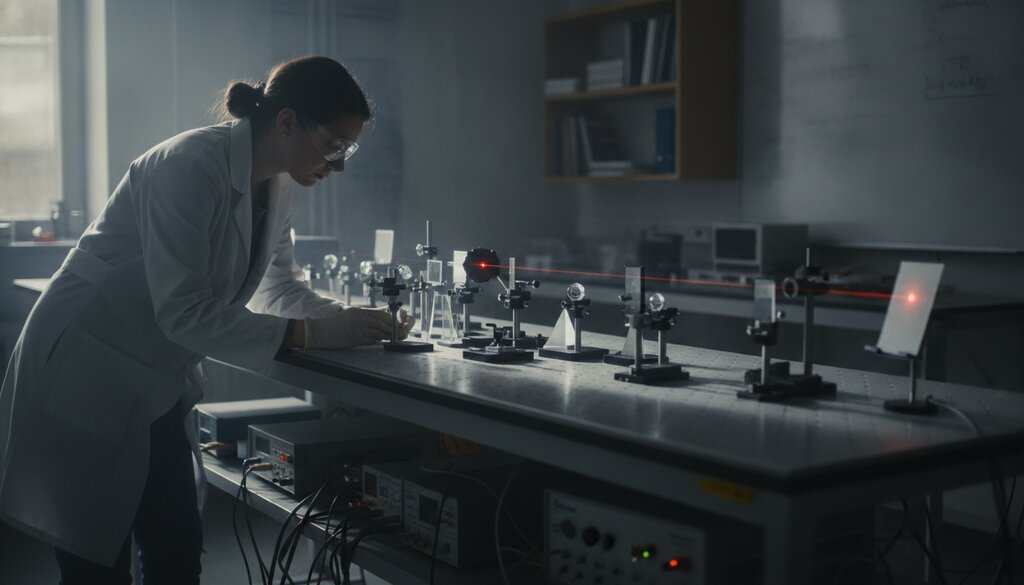
Gangbare detectors sturen elke video afzonderlijk door een digitaal model. De UCLA-opstelling, van het lab van hoogleraar Aydogan Ozcan met Parnian Ghapandar Kashani en Shiqi Chen als gelijkwaardige eerste auteurs, vervangt die eerste stap door een stapel passieve diffractieve laagjes. Het licht dat door die laagjes reist, verwerkt de beelden terwijl het zich voortplant. Vijftien videostromen gaan zo in één optische passage naar binnen en komen gescheiden naar buiten, waarna een kleine elektronische decoder de uitslag leest.
Omdat die laagjes niets schakelen, verbruiken ze tijdens het analyseren geen stroom. De energie zit alleen nog in de decoder. Dat is het hele punt van de aanpak: het volume aan AI-video dat gecontroleerd moet worden groeit sneller dan de rekencapaciteit die er tegenover staat.
Wat de cijfers zeggen
Op de Celeb-DF-dataset haalde het systeem 97,79 procent gemiddelde nauwkeurigheid bij vijftien parallelle video’s, met een sensitiviteit van 99,86 procent en een specificiteit van 95,72 procent. Opgeschaald naar achttien video’s zakte de nauwkeurigheid naar 96,13 procent. Op materiaal van Google VEO-3 kwam de detector na beperkte bijsturing op 94,80 procent uit.
Die scheve verhouding tussen sensitiviteit en specificiteit is bewust gekozen. Het systeem mist bijna geen nepvideo, maar wijst wel echte video’s aan als verdacht. De auteurs noemen hun opstelling daarom een voorselectie met hoge gevoeligheid, geen vervanging van bestaande digitale detectors. Wat eruit komt als twijfelgeval gaat door naar zwaardere software.
Lastiger te misleiden
Een tweede eigenschap valt op in de publicatie: de detector blijkt moeilijk te foppen met adversarial voorbeelden, zowel in black-box- als white-box-tests. De reden is fysiek. De parameters van het model zitten in de vorm en de stand van de optische laagjes, niet in een gewichtsbestand dat een aanvaller kan uitlezen of nabootsen. Daarmee vervalt een deel van de standaardtrucs waarmee digitale detectors onderuit worden gehaald.
Herkenning van AI-materiaal loopt nu vooral via markering aan de bron, zoals de watermerktechniek die DeepMind zelfs in ontworpen eiwitten stopt. Zulke watermerken werken alleen bij modellen die meewerken. Detectie achteraf blijft daarom nodig, zeker nu generatieve video goedkoper wordt en pratende avatars in realtime binnen bereik komen van gewone gebruikers.
Wat betekent dit
Voor redacties, platforms en toezichthouders is de bottleneck niet of een deepfake te herkennen is, maar tegen welke kosten je miljoenen uploads per dag kunt nakijken. Een optische voorselectie die nauwelijks stroom vraagt, verschuift die rekening. Tegelijk gaat het om een laboratoriumopstelling: er is geen product, geen prijs en geen leverancier. Dat het beeldaanbod blijft groeien is wel zeker, zie de verschuivingen bij videomodellen rond het stopzetten van de Sora-API. En wetgevers lopen vooruit op de techniek: New York eist al keuring en een killswitch voor AI-systemen. Wie aan die eisen moet voldoen, heeft controle nodig die opschaalt zonder een datacenter erbij.