
Alibaba geeft animatiemodel Wan-Animate-2 vrij
Alibaba heeft Wan-Animate-2 opengegooid, een model dat een stilstaand personage laat bewegen op basis van een gewone video. De gewichten, de inferentiecode en het technische paper staan sinds 7 augustus onder Apache 2.0-licentie op GitHub en Hugging Face, meldt Open Source For You. Wie een figuur wil laten dansen, gebaren of praten heeft daarmee geen commerciele dienst meer nodig.
Geen skelet meer nodig
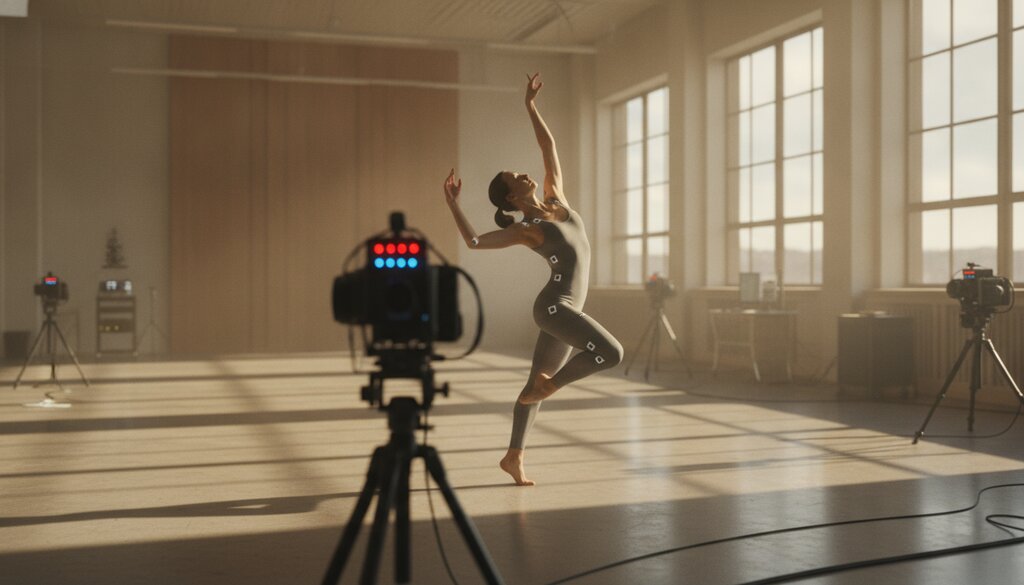
De meeste animatietools zetten een video eerst om in een skelet van gewrichtspunten en projecteren die houdingen daarna op het personage. Dat gaat mis bij handen, gezichtsuitdrukkingen en ongebruikelijke lichaamsbouw. Het team van Tongyi Lab slaat die tussenstap over en voert de ruwe videolatenten rechtstreeks in een aangepaste Diffusion Transformer met twee takken, uitgelijnd via temporele RoPE. In het paper op arXiv beschrijven de onderzoekers dat het model daardoor fijne details behoudt en het gezicht niet langzaam verandert in iemand anders, een klassiek probleem bij langere clips.
Er zit ook camerasturing in. Via een aparte Viewpoint LoRA kun je met een tekstinstructie het camerastandpunt losknippen van de bronvideo, zodat dezelfde beweging vanuit een andere hoek wordt gerenderd. Meerdere personages tegelijk aansturen kan zonder hertraining, net als afwijkende beeldverhoudingen.
24 beelden per seconde op eigen hardware
Naast het volledige model is er Wan-Animate-2-Lite, dat volgens Open Source For You realtime streamt op 24 frames per seconde bij een resolutie van 400 bij 720 pixels. Er zijn gekwantiseerde varianten in INT8 en BF16, en het model werkt direct samen met ComfyUI en DiffSynth-Studio. Dat maakt het bereikbaar voor kleine studio’s en losse makers, niet alleen voor partijen met een serverpark.
Blinde gebruikerstests in het paper zetten Wan-Animate-2 naast gesloten diensten als Dreamina van ByteDance en KLING MotionControl van Kuaishou. Volgens die tests wint of evenaart het open model. Dat is de aanpak die Alibaba vaker gebruikt: eerst marktaandeel winnen met vrij beschikbare gewichten, daarna nadenken over verdienmodel. Bij de taalmodellen zagen we hetzelfde patroon, tot en met het plan om een omzetdeel te vragen van grote Qwen-gebruikers en de vertraagde publicatie van Qwen3.8.
Wat betekent dit
Voor videomakers verschuift de rekensom. Animatie die eerst uren handwerk of een abonnement kostte, draait nu op een pc met een stevige videokaart. Diezelfde beweging zie je bij taalmodellen, waar Meta onlangs Muse Glimmer op consumentenhardware zette.
De keerzijde is bekend. Een model dat een gezicht overtuigend laat bewegen op basis van een filmpje, laat ook het gezicht van iemand anders bewegen. Japan koos daarom voor expliciete toestemming bij stemklonen, en platforms worstelen nog met herkenning: YouTube zag zelfs handgemaakt werk van Kurzgesagt aan voor AI-productie. Een Apache 2.0-licentie legt die vraag bij de gebruiker neer, niet bij Alibaba. Wie hier iets mee bouwt, doet er verstandig aan zelf vast te leggen wiens beeltenis in beweging wordt gebracht en met welke toestemming.
Lees ook

Google schreef mee aan Amerikaanse chatbotwetten

Grok 4.7 is goedkoop, maar blijft achter op codeertests
